摘要
Kimi 官方文档写明 K3.1 Pro 与 K3 “始终开启思考” “目前关不了”,只提供降低强度的 reasoning_effort。我在研究 K3.1 Pro 时发现,沿用 K2 时代的关闭写法 thinking: {"type": "disabled"},这两个模型都不会报错,思考过程也确实停了。对 K3.1 Pro 实测:
- 提取类任务(如:看图提取、JSON 文本提取、结构化输出、批量分类、长文本条款查找):耗时缩短到原来的 1/2~1/4,输出 token 减少 73%~85%,结果与开启思考时完全一致;
- 工具调用:官方写明思考开启时“强制调用指定函数”会返回 400,关闭思考后可以正常调用;
- 不适合的场景:多步数值计算(如:双倍余额递减法求折旧)关闭思考后 2 次都答错,开启思考 2 次都答对;
- 接口差异:Chat Completions 与 Messages API(Anthropic 兼容)都认这个参数;Responses API 返回 200,但静默忽略了它,照样思考。
本文给出完整的 Python 复现代码、原始数据,以及生产环境的降级方案。
这是未写进官方文档的行为,随时可能变化。
一、为什么要关掉思考
在审计业务场景中,有一些工作是不需要多步推理的,比如把银行回单、发票、采购合同、询证函回函等扫描件按底稿字段转写成结构化表格,把银行流水或序时账摘要批量归入费用科目,或者在几十页的长合同里找出特定条款。这些活的答案直接印在页面或文本里,把字认准、按格式填对就够了。
对这类任务开启思考,往往吃力不讨好。一个审计项目动辄要处理成百上千份合同与凭证,每次请求都先花几秒生成一两百个思考 token,整批任务的等待时间和输出费用都会成倍放大。更麻烦的是,不少模型在思考阶段会先把原文用自然语言复述一遍,再根据这段复述整理出 JSON——中间多绕一道转述,原本印得很清楚的编号、金额或日期格式反而容易在二次改写时走样。在 Kimi K3 上,开启思考还会触发接口层面的限制,比如无法强制调用指定函数。
因此在单据提取、流水归类这类场景里,默认关掉思考更稳妥,只把思考留给折旧重算、跨表勾稽等确实需要多步推导的任务。Kimi K2 时代可以通过参数直接关闭;等到模型升级到 K3 系列,麻烦出现了:官方文档写明 K3 关不了思考。
二、官方文档怎么说
以下内容摘自 2026-10-24 的 Kimi 开放平台文档。
kimi-k3.1-pro始终进行推理且保留式思考始终开启,无需(也不应)传入thinking参数;只需指定model,并按需通过顶层reasoning_effort调节推理强度。
Kimi K3.1 Pro 快速开始 的常见问题:
目前关不了,K3.1 Pro 始终开启思考模式。如果觉得思考过程太长,可以将
reasoning_effort设置为low降低推理强度。
thinking是 K2.x 专属请求参数。
kimi-k3.1-pro和kimi-k3.1-pro-highspeed的参数约束也与kimi-k3完全一致。表中“固定”表示该参数不可修改:传入其他值会报错,建议不要显式传入。
同一张参数表里,temperature 对 K3 标为“固定 1.0”,thinking 一栏是“—”。换句话说,参数表把 thinking 归为“不适用”,并未像 temperature 那样标成“传入其他值会报错”。
推理强度:
Kimi K3.1 Pro 始终进行推理,并通过请求顶层
reasoning_effort配置推理强度。该字段支持"low"/"high"/"max"三档,默认"max"。
文档里还有两处限制与思考模式直接相关,后文实验会一并验证。
指定函数调用当前与思考开启不兼容:思考开启时传入会返回 400 错误(
tool_choice 'specified' is incompatible with thinking enabled)。
注意
max_tokens会优先被思考消耗:kimi-k3.1-pro默认开启思考,max_tokens设置较小时,截断点可能落在思考阶段——此时content仍为空、finish_reason已是length。
三、测试方法
3.1 环境
| 项 | 取值 |
|---|---|
| 测试日期 | 2026-10-24 |
| 端点 | 主域名 https://api.moonshot.cn;路径为 /v1 与 /anthropic/v1/messages |
| 客户端 | Python 3.15.0,openai SDK 3.37.0 |
| 账户等级 | Tier0(官方限速每分钟 3 次请求) |
| 网络 | 直连,不经本地代理 |
| 型号 | kimi-k3.1-pro、kimi-k3;对照组另用 kimi-k2.7-code |
kimi-k3.1-pro-highspeed 在测试账户上返回 404(resource_not_found_error),/v1/models 列表中也没有它,因此未测。
3.2 如何判断“真的关掉了”
单看 HTTP 200 不能说明参数生效——不少 OpenAI 兼容接口遇到未知字段会直接忽略,照常返回 200(6.6 节就有现成例子)。因此每组请求同时核对以下四项:
1.usage.completion_tokens_details.reasoning_tokens:思考 token 数;
2.message.reasoning_content:思考内容的长度;
3.usage.completion_tokens:输出 token 总数(即计费口径);
4.端到端耗时;流式请求另记首个思考片段与首个正文片段到达的时间。
同时检查答案是否正确,确认关闭思考没有让结果变差。
3.3 实验设计
核心实验(kimi_thinking_probe.py):
- 实验一:文本。一道库存加减题(标准答案 1219),非流式请求。三种写法:不传参数(默认)、
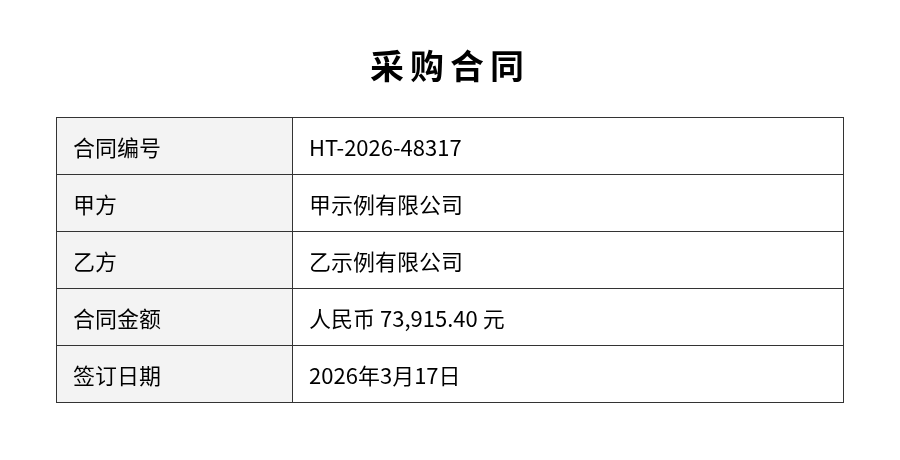
thinking: {"type": "disabled"}、reasoning_effort="low"。每个型号、每种写法各跑 3 次。 - 实验二:看图提取。一张合成的采购合同图(5 个字段,标准答案只出现在图片里,甲乙双方使用“甲示例有限公司”“乙示例有限公司”虚构名称),请求参数按线上提取流程的常见组合设置:
stream=True+response_format={"type": "json_object"}+stream_options={"include_usage": True}。对比默认与thinking=disabled,每个型号、每种写法各跑 2 次。 - 实验三:对照组。向 K3.1 Pro 发送官方标为“固定”的
temperature=0,以及向官方写明传disabled会报错的kimi-k2.7-code发送thinking=disabled,确认服务端会拒绝非法参数。
拓展实验(kimi_thinking_explore.py,见第六节)只测 kimi-k3.1-pro,逐项对比默认与 thinking=disabled,覆盖 JSON Mode 文本提取、Structured Output、批量分类、工具调用(含指定函数)、多轮对话中途切换、Partial Mode、长文本、推理题,以及 Messages API 与 Responses API。
为排除限速干扰,测试关闭了 SDK 自动重试(避免 429 重试计入耗时),每次请求后固定间隔 21 秒。
测试用图:
四、代码示例
4.1 关键写法
OpenAI Python SDK 没有原生的 thinking 参数,需要放进 extra_body;reasoning_effort 则是 SDK 的标准参数。
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["MOONSHOT_API_KEY"],  # sk-****,不要把 Key 写进代码
    base_url="https://api.moonshot.cn/v1",
)

messages = [{"role": "user", "content": "……"}]

# 写法一:默认,始终思考(官方行为)
client.chat.completions.create(model="kimi-k3.1-pro", messages=messages)

# 写法二:K2 时代的关闭写法,官方文档未提及对 K3 有效
client.chat.completions.create(
    model="kimi-k3.1-pro",
    messages=messages,
    extra_body={"thinking": {"type": "disabled"}},
)

# 写法三:官方给 K3 的方案,只能降低强度
client.chat.completions.create(model="kimi-k3.1-pro", messages=messages, reasoning_effort="low")
4.2 读取思考指标
reasoning_content 不是 OpenAI 标准字段,SDK 会把它保留在消息对象上,用 getattr 读取:
resp = client.chat.completions.create(...)
msg = resp.choices[0].message
details = resp.usage.completion_tokens_details

print("输出 token:", resp.usage.completion_tokens)
print("思考 token:", details.reasoning_tokens if details else None)
print("思考内容字数:", len(getattr(msg, "reasoning_content", None) or ""))
4.3 流式看图提取
import base64

image_b64 = base64.b64encode(open("synthetic-contract.png", "rb").read()).decode()

stream = client.chat.completions.create(
    model="kimi-k3.1-pro",
    stream=True,
    stream_options={"include_usage": True},
    response_format={"type": "json_object"},
    messages=[{
        "role": "user",
        "content": [
            # K3 系列视觉输入只支持 base64 或 ms://<file-id>,不支持公网图片 URL
            {"type": "image_url", "image_url": {"url": f"data:image/png;base64,{image_b64}"}},
            {"type": "text", "text": '请识别图片中的合同信息,仅返回一个 JSON 对象,字段为 "合同编号"、"甲方"、"乙方"、"合同金额"、"签订日期"……'},
        ],
    }],
    extra_body={"thinking": {"type": "disabled"}},
)

content, usage = "", None
for chunk in stream:
    if chunk.usage:  # include_usage 时最后一片单独携带用量,choices 为空
        usage = chunk.usage
    if chunk.choices and chunk.choices[0].delta.content:
        content += chunk.choices[0].delta.content
4.4 强制调用指定函数
resp = client.chat.completions.create(
    model="kimi-k3.1-pro",
    messages=[{"role": "user", "content": "2026年3月17日 1 美元兑人民币中间价是多少?……"}],
    tools=[FX_TOOL],  # get_fx_rate(currency, date),完整定义见附录 A
    tool_choice={"type": "function", "function": {"name": "get_fx_rate"}},
    # 不带下面这行时返回 400:tool_choice 'specified' is incompatible with thinking enabled
    extra_body={"thinking": {"type": "disabled"}},
)
4.5 Messages API(Anthropic 兼容)
Messages API 的请求体本身就有 thinking 字段,直接写在顶层:
import json
import os
import urllib.request

request = urllib.request.Request(
    "https://api.moonshot.cn/anthropic/v1/messages",
    data=json.dumps({
        "model": "kimi-k3.1-pro",
        "max_tokens": 4096,
        "messages": [{"role": "user", "content": "……"}],
        "thinking": {"type": "disabled"},
    }).encode(),
    headers={
        "x-api-key": os.environ["MOONSHOT_API_KEY"],
        "anthropic-version": "2023-06-01",
        "content-type": "application/json",
    },
)
with urllib.request.urlopen(request, timeout=600) as r:
    body = json.loads(r.read())
print([block["type"] for block in body["content"]])  # 关闭后只剩 ["text"]
完整脚本(含计时、结果核对与数据落盘)见附录 A。
五、核心实验结果
5.1 实验一:文本(每组 3 次)
| 指标 | 默认 | 关闭思考disabled |
降低强度low |
|---|---|---|---|
型号:kimi-k3.1-pro |
|||
| 平均耗时 | 4.40 秒 | 2.13 秒 | 2.72 秒 |
| 平均输出 token | 195.7 | 17.7 | 71.7 |
| 思考 token(3 次) | 206 / 138 / 174 | 不返回 | 31 / 46 / 69 |
| 思考内容 | 257~367 字 | 0 字 | 63~124 字 |
| 答案正确 | 3/3 | 3/3 | 3/3 |
型号:kimi-k3 |
|||
| 平均耗时 | 4.18 秒 | 1.46 秒 | 6.95 秒* |
| 平均输出 token | 138.3 | 15.0 | 114.3 |
| 思考 token(3 次) | 141 / 95 / 117 | 不返回 | 71 / 97 / 115 |
| 思考内容 | 174~262 字 | 0 字 | 131~208 字 |
| 答案正确 | 3/3 | 3/3 | 3/3 |
* kimi-k3 的 reasoning_effort=low 有一次耗时 14.61 秒,中位数为 3.52 秒,判断是服务端排队造成的偶发长尾。
5.2 实验二:看图提取(每组 2 次)
| 指标 | 默认 | 关闭思考(disabled) |
|---|---|---|
型号:kimi-k3.1-pro |
||
| 总耗时(各次) | 6.45 / 7.46 秒 | 2.73 / 3.58 秒 |
| 首个正文到达 | 5.83 / 6.91 秒 | 2.14 / 3.02 秒 |
| 输入 token | 744 | 677 |
| 输出 token | 261 / 268 | 58 / 58 |
| 思考 token | 198 / 205 | 不返回 |
| 命中字段 | 5/5、5/5 | 5/5、5/5 |
| 单次估算费用 | ¥0.0277 | ¥0.0127 |
型号:kimi-k3 |
||
| 总耗时(各次) | 4.64 / 4.15 秒 | 2.72 / 6.63 秒 |
| 首个正文到达 | 4.00 / 3.48 秒 | 1.81 / 6.02 秒 |
| 输入 token | 744 | 677 |
| 输出 token | 160 / 174 | 55 / 55 |
| 思考 token | 99 / 113 | 不返回 |
| 命中字段 | 5/5、5/5 | 5/5、5/5 |
| 单次估算费用 | ¥0.0316 | ¥0.0190 |
关闭思考时,流式响应里没有任何 reasoning_content 片段,第一片就是正文。
看耗时需要放在同一时段比对。kimi-k3 关闭思考的第 2 次请求,首个正文到 6.02 秒才出现,中间并没有任何思考片段,同样属于服务端排队延迟。换图前(17:42)我用相同参数测过另一张仅公司名不同的合同图,当时 K3.1 Pro 平均耗时从 4.98 秒降到 1.73 秒;18:16 这一轮则是从 6.96 秒降到 3.16 秒,整体慢了 40%~80%。绝对耗时随服务端负载波动较大,token 用量则很稳定:两轮平均输出 token 分别是 269 → 61 和 265 → 58。
估算费用按官方定价(2026-10-24)计算:K3.1 Pro 输入 ¥13、输出 ¥68,K3 输入 ¥20、输出 ¥100,单位均为每百万 token。计算时把输入全部按未命中缓存计价,未细分缓存写入与命中,只用于比较相对差异。按此口径,关闭思考后 K3.1 Pro 单次看图请求省约 54%,K3 省约 40%。
5.3 实验三:对照组
| 测试项 | 结果 |
|---|---|
kimi-k3.1-pro 传 temperature=0 |
HTTP 400invalid_request_error |
kimi-k2.7-code 传 thinking=disabled |
六、看图之外:还能用在哪
以下实验只测 kimi-k3.1-pro。耗时与 token 列出每一次的值;“—”表示响应中不返回该字段。
6.1 提取类任务:全部更快,结果不变
| 指标 | 默认 | 关闭思考(disabled) |
|---|---|---|
| JSON Mode 文本提取(5 个字段) | ||
| 耗时(秒) | 6.71 / 8.46 | 2.34 / 3.45 |
| 输入 token | 301 | 234 |
| 输出 token | 300 / 357 | 75 / 75 |
| 思考 token | 221 / 277 | — |
| 结果 | 5/5、5/5 | 5/5、5/5 |
Structured Output(json_schema 严格模式) |
||
| 耗时(秒) | 8.42 | 2.16 |
| 输入 token | 379 | 312 |
| 输出 token | 332 | 57 |
| 思考 token | 261 | — |
| 结果 | 结构、金额、付款比例都正确 | |
| 批量分类(10 条流水摘要归入费用科目) | ||
| 耗时(秒) | 4.80 / 4.11 | 1.78 / 1.99 |
| 输入 token | 301 | 234 |
| 输出 token | 214 / 154 | 55 / 45 |
| 思考 token | 164 / 104 | — |
| 结果 | 10/10、10/10 | 10/10、10/10 |
| 长文本条款查找(120 条、17,681 字的合同) | ||
| 耗时(秒) | 7.15 | 2.36 |
| 输入 token | 9879 | 9812 |
| 输出 token | 278 | 43 |
| 思考 token | 230 | — |
| 结果 | 两处条款都对 | |
文档提取工具日常跑的就是这几类活:OCR 后的文本抽取、按固定结构输出给下游系统、流水摘要批量归类,以及在长合同里找特定条款。关闭思考后,耗时降到原来的 1/2.4~1/3.9,输出 token 减少 73%~85%,提取结果与开启思考完全一致。
6.2 工具调用:解锁“强制调用指定函数”
工具 get_fx_rate(currency, date) 查询外币汇率,问题是“2026年3月17日 1 美元兑人民币中间价是多少?请先查询,再计算 3,500 美元折合人民币多少元”。
| 指标 | 默认 | 关闭思考(disabled) |
|---|---|---|
tool_choice = "auto" |
||
| HTTP | 200 | 200 |
| 耗时(秒) | 2.86 | 2.55 |
| 输出 token | 115 | 100 |
| 思考 token | 42 | — |
| 结果 | 调用 get_fx_rate,参数正确 |
|
tool_choice = "required" |
||
| HTTP | 200 | 200 |
| 耗时(秒) | 3.36 | 2.36 |
| 输出 token | 137 | 68 |
| 思考 token | 64 | — |
| 结果 | 调用 get_fx_rate,参数正确 |
|
tool_choice 指定函数(get_fx_rate) |
||
| HTTP | 400 | 200 |
| 耗时(秒) | — | 3.71 |
| 输出 token | — | 92 |
| 思考 token | — | — |
| 结果 | tool_choice 'specified' is incompatible with thinking enabled |
调用 get_fx_rate,参数正确 |
默认模式下确实如文档所说返回了 400;加上关闭参数后报错消失,指定函数正常触发。像抽取流水线里“这一步只许调用 save_record”的场景,此前在 K3 上只能退而用 required,现在可以直接指定函数名。
完整回合(模型发起调用 → 回传模拟的汇率 7.1234 → 模型给出最终答案 24,931.90 元):
| 阶段 | 默认 | 关闭思考 |
|---|---|---|
| 第 1 步(耗时 / 输出 token) | 4.81 秒 / 169 | 3.55 秒 / 100 |
| 第 2 步(耗时 / 输出 token) | 5.84 秒 / 288 | 3.34 秒 / 131 |
| 合计 | 10.65 秒 / 457 | 6.89 秒 / 231 |
| 最终答案 | 正确 | |
6.3 多轮对话:可以中途切换
第 1 轮让模型记住“重要性水平 120 万元,实际执行的重要性按其 75% 确定”,第 2 轮问实际执行的重要性(90 万元)。第 2 轮的请求原样带上第 1 轮返回的完整 assistant message。
| 指标 | 组合一 | 组合二 | 组合三 |
|---|---|---|---|
| 第 1 轮 | 关闭 | 默认 (思考 64 token) |
关闭 |
| 第 2 轮 | 关闭 | 关闭 | 默认 |
| 第 2 轮 HTTP | 200 | 200 | 200 |
| 第 2 轮输入 token | 90 | 90 | 163 |
| 第 2 轮思考 token | — | — | 34 |
| 答案 | 正确 | ||
三种组合都能正常衔接,可以按轮次决定要不要思考,比如闲聊轮关、复杂问题轮开。
这里有个细节:“默认 → 关闭”的第 2 轮输入同样只有 90 token,与“关闭 → 关闭”一致。尽管第 1 轮返回的 64 token 思考内容随历史消息一起传了回去,第 2 轮的输入计数并没有算上它,说明关闭思考的那一轮不会把历史 reasoning_content 计入上下文,K3 的保留式思考在关闭时不生效。依赖历史思考内容的 Agent 流程,不宜中途关闭。
6.4 Partial Mode:截断不再落在思考里
| 指标 | 默认 | 关闭思考(disabled) |
|---|---|---|
用法一:固定开头 {"结论": " |
||
| 耗时(秒) | 2.52 | 3.45 |
| 输入 token | 122 | 55 |
| 输出 token | 59 | 72 |
| 思考 token | — | — |
| 结果 | 拼接后是合法 JSON | |
用法二:max_tokens=60 截断 |
||
| 耗时(秒) | 2.57 | 3.14 |
| 输入 token | 101 | 34 |
| 输出 token | 60 | 60 |
| 思考 token | 57 | — |
| 结束原因 | finish_reason = "length" |
|
| 截断时正文 | 0 字 | 117 字 |
开启思考时确实撞上了文档提醒的问题:60 个 token 的额度有 57 个耗在思考上,正文一个字没出来就因 length 截断了,“续写被截断的输出”也就无从谈起。关掉思考后,额度全部留给了正文。
另外,传入固定开头时,就算不带关闭参数,本次也没有生成思考内容。
6.5 推理题:什么时候不该关
| 指标 | 默认 | 关闭思考(disabled) |
|---|---|---|
| 日期推算(第 100 天是哪天、星期几) | ||
| 耗时(秒) | 10.26 / 7.11 | 1.15 / 1.03 |
| 输出 token | 499 / 295 | 27 / 27 |
| 答对 | 2/2 | 2/2 |
| 双倍余额递减法求第 4 年折旧 | ||
| 耗时(秒) | 6.97 / 7.02 | 1.73 / 3.12 |
| 输出 token | 271 / 232 | 21 / 21 |
| 答对 | 2/2 | 0/2 |
| 真话假话逻辑题 | ||
| 耗时(秒) | 8.02 / 8.47 | 1.73 / 1.51 |
| 输出 token | 295 / 285 | 18 / 18 |
| 答对 | 2/2 | 2/2 |
双倍余额递减法要先逐年算折旧、最后两年再改用直线法,中间结果一环扣一环。关闭思考后模型直接给出数字,2 次都错;开启思考 2 次都对。另外两题关闭思考也答对了,但样本只有 2 次,不能说明关闭思考在推理题上稳定可靠。
取舍边界很清楚:答案就在输入里的任务(提取、分类、改写)可以关;答案要靠多步推导得出的任务(计算、规划)应该开着。
6.6 其他接口:Responses API 会静默忽略
同一道库存题,分别走 Messages API(Anthropic 兼容)与 Responses API:
| 指标 | 默认 | 传入关闭参数 |
|---|---|---|
| Messages API(Anthropic 兼容) | ||
| 写法 | 不传 | 顶层 thinking: {"type": "disabled"} |
| HTTP | 200 | 200 |
| 耗时(秒) | 4.64 | 2.42 |
| 输出内容 | thinking + text 两个内容块 |
只有 text |
| 输出 token(其中思考) | 155(133) | 18(—) |
| Responses API | ||
| 写法 | 不传 | extra_body 带 thinking |
| HTTP | 200 | 200 |
| 耗时(秒) | 3.86 | 4.78 |
| 输出内容 | reasoning + message |
仍有 reasoning |
| 输出 token(其中思考) | 89(67) | 160(137) |
Messages API 原生支持顶层 thinking 字段,按 Anthropic 的写法传入即可生效。Responses API 则印证了前文说的“返回 200 却没生效”:thinking 不在它的参数定义里,被服务端直接丢弃,模型照常思考。Responses API 在 K3 上只定义了 reasoning.effort(low / high / max),本次未找到关闭写法。
七、结果解读
1.思考确实被关掉了,而不只是隐藏了思考内容。 有三个独立现象可以佐证:
- 计费口径的输出 token 大幅下降。如果服务端只是不回传思考内容,计费的输出 token 不会变少;
- 端到端耗时降到原来的 1/2~1/4,首个正文片段直接到达,没有思考阶段;
- 输入 token 固定少 67 个。本文所有参数生效的单轮请求(Responses API 那组参数被忽略,不在此列;文本实验未记录输入 token),关闭思考的输入 token 都比默认少 67 个:看图 744 → 677,JSON 文本提取 301 → 234,工具调用 224 → 157,长文本 9879 → 9812,Messages API 145 → 78,多轮对话首轮 113 → 46,等等。输入内容一字未改,差值却固定为 67,说明思考模式下服务端会额外拼接一段约 67 token 的提示模板,关闭后走的是另一条处理路径。多轮对话第 2 轮的差额是 73 个(163 对 90),多出的部分来自多轮场景的模板差异,具体组成无法从外部判断。
以上是根据可观测指标做出的推断,服务端的内部实现从外部看不到。
2.服务端更像是保留了兼容 K2 的处理分支,而非漏做参数校验。 对照组里,服务端对 K3.1 Pro 的固定参数校验很严(temperature=0 直接返回 400),也会对 kimi-k2.7-code 明确拒绝 thinking=disabled。唯独在 K3.1 Pro 与 K3 上,thinking=disabled 不仅通过了校验、关掉了思考,还同步解除了“指定函数调用”这条与思考绑定的限制,更像是为兼容 K2 迁移留下的完整路径。
3.提取类任务关闭思考后准确率未见下降。 看图、JSON 文本提取、结构化输出、批量分类、长文本查找,关闭思考的每一次结果都与开启思考一致。需要说明的是,每组只有 1~3 次,样本是清晰的合成数据,不能替代真实业务数据上的实测评估。
4.reasoning_effort="low" 不能替代关闭。 文本实验里,它把思考 token 压到了 31~115,但始终大于零,耗时也慢于直接关闭(K3.1 Pro 均值 2.72 秒对 2.13 秒;K3 避开偶发长尾看中位数,3.52 秒对 1.45 秒)。
八、风险与生产落地建议
这是官方文档未承诺的行为,官方原话是“无需(也不应)传入”。生产环境若要使用,建议做好以下防护:
1.按任务类型决定开关。提取、分类、改写、长文本查找这类“答案就在输入里”的任务关掉思考;涉及多步计算与推导的任务保持开启,或把计算交给代码、模型只负责抽取数字。
2.给“被拒绝”留降级路径。服务端哪天开始拒绝这个参数时,HTTP 400 的错误体通常会点名 thinking。捕获后去掉该参数重发,并按 Base URL 与模型组合缓存结论,后续请求直接不带。只有错误体明确点名参数时才降级,避免把内容审核类的 400(Kimi 的 content_filter 也是 HTTP 400)误判为参数不兼容。
3.防“被忽略”。Responses API 已经是现成的例子:返回 200,照样思考。换接口、换 SDK 或服务端升级后,都要核对 reasoning_tokens 是否归零、输入 token 是否少了 67 个,不要只看请求成功。依赖“指定函数调用”的流程,参数一旦失效会直接收到 400,这类流程要单独做好兜底。
4.只对实测过的调用名生效。用精确匹配,不要用 kimi-k3* 这样的前缀。本文没测到的高速版和以后的新型号,都要单独验证后再加入。
5.依赖历史思考内容的流程慎用。关闭思考的轮次不把历史 reasoning_content 计入上下文(见 6.3 节)。工具调用较多、需要模型记住前几轮推理的 Agent,不宜中途关闭。
6.每次升级都重测。附录 A 的两个脚本可以直接复用。
九、在 MaoKit 中的落地
专为注册会计师打造的审计工具箱 MaoKit 在 v0.20.0 中已按上述方案调整:
kimi-k3.1-pro与kimi-k3默认带上thinking: {"type": "disabled"},“AI配置”里的“深度思考”开关对 Kimi 重新可用。打开开关就不发这个参数,恢复官方默认的思考模式。- 匹配规则只覆盖这两个调用名;
kimi-k2.7-code明确排除,因为官方写明它传disabled会报错,对照组也验证了这一点。 - 请求层沿用已有的降级逻辑:400 错误体点名
thinking时,自动去掉参数重发并缓存结论。
MaoKit 的信息提取走 Chat Completions 流式接口,对应 5.2 节的看图实验与 6.1 节的文本提取场景,属于关闭思考收益最明显、准确率风险也最低的一类任务。
同一轮里,我也按 3.2 节的方法核对了其他几家预设模型的关闭写法。DeepSeek、小米 MiMo、阿里千问都满足“默认有思考 token,带上关闭参数后归零”。只看 HTTP 200 判断参数是否生效,在哪家都不可靠。
附录 A:完整测试脚本
运行方式:
export MOONSHOT_API_KEY=sk-****
uv run --no-project --with openai python kimi_thinking_probe.py
uv run --no-project --with openai python kimi_thinking_explore.py
如果本机设置了 SOCKS 代理(ALL_PROXY=socks5://...),httpx 需要额外的 socksio 依赖,否则创建客户端时会报 ImportError,可加上 --with socksio,或把 api.moonshot.cn 加进 NO_PROXY 直连。
本文的看图数据来自更换测试图后单独重跑的一轮:脚本逐项调用 image_probe(),文本与对照组沿用第一轮的结果。直接运行 kimi_thinking_probe.py 会把三项实验完整跑一遍。
A.1 核心实验:kimi_thinking_probe.py
"""Kimi K3 / K3.1 Pro 关闭思考实测脚本。

用法:
    export MOONSHOT_API_KEY=sk-****            # 不要把 Key 写进代码或命令历史
    uv run --no-project --with openai python kimi_thinking_probe.py

输出:逐条打印每次请求的指标,并把原始指标追加写入同目录的 results.jsonl。
只记录 HTTP 状态、耗时、token 用量、思考内容长度与是否命中地面真相,不记录 Key 与模型正文。
"""

import base64
import json
import os
import platform
import time
from pathlib import Path

import openai
from openai import OpenAI

HERE = Path(__file__).resolve().parent
RESULTS = HERE / "results.jsonl"
IMAGE = HERE / "synthetic-contract.png"

# 新账户 Tier0 每分钟 3 次请求,每次请求后间隔 21 秒,避免 429 干扰耗时数据
REQUEST_GAP_SECONDS = 21

client = OpenAI(
    api_key=os.environ["MOONSHOT_API_KEY"],
    base_url="https://api.moonshot.cn/v1",
    max_retries=0,  # 关闭 SDK 自动重试,否则 429 重试会被算进耗时
    timeout=300,
)

TEXT_PROMPT = (
    "一个仓库月初库存 1280 件,本月三次入库分别为 315、472、198 件,"
    "两次出库分别为 640、389 件,月末又盘亏 17 件。"
    '只返回一个 JSON:{"月末库存": 数字},不要输出其他文字。'
)
TEXT_ANSWER = 1219

IMAGE_PROMPT = (
    "请识别图片中的合同信息,仅返回一个 JSON 对象,字段为"
    ' "合同编号"、"甲方"、"乙方"、"合同金额"、"签订日期",值照图片原文填写;'
    "不要输出 JSON 以外的文字。"
)
GROUND_TRUTH = {
    "合同编号": ["HT-2026-48317"],
    "甲方": ["甲示例有限公司"],
    "乙方": ["乙示例有限公司"],
    "合同金额": ["73,915.40", "73915.40", "73915.4"],
    "签订日期": ["2026年3月17日", "2026-03-17", "2026-3-17"],
}

# 三种请求写法:不传参数(默认)、K2 时代的关闭写法、官方给 K3 的降强度写法
VARIANTS = {
    "默认": {},
    "thinking=disabled": {"extra_body": {"thinking": {"type": "disabled"}}},
    "reasoning_effort=low": {"reasoning_effort": "low"},
}


def record(row: dict) -> None:
    print(json.dumps(row, ensure_ascii=False))
    with RESULTS.open("a", encoding="utf-8") as f:
        f.write(json.dumps(row, ensure_ascii=False) + "\n")


def reasoning_tokens(usage) -> int | None:
    details = getattr(usage, "completion_tokens_details", None)
    return getattr(details, "reasoning_tokens", None) if details else None


def parse_json(text: str) -> dict:
    try:
        return json.loads(text.strip().removeprefix("```json").removesuffix("```"))
    except (json.JSONDecodeError, AttributeError):
        return {}


def text_probe(model: str, variant: str, run: int) -> None:
    """非流式文本请求:对比思考 token、思考内容长度与耗时。"""
    started = time.perf_counter()
    try:
        resp = client.chat.completions.create(
            model=model,
            messages=[{"role": "user", "content": TEXT_PROMPT}],
            **VARIANTS[variant],
        )
    except openai.APIStatusError as e:
        record({"实验": "文本", "模型": model, "写法": variant, "轮次": run,
                "HTTP": e.status_code, "错误类型": (e.body or {}).get("type")})
        return
    elapsed = time.perf_counter() - started
    msg = resp.choices[0].message
    answer = parse_json(msg.content).get("月末库存")
    record({
        "实验": "文本", "模型": model, "写法": variant, "轮次": run, "HTTP": 200,
        "耗时秒": round(elapsed, 2),
        "completion_tokens": resp.usage.completion_tokens,
        "reasoning_tokens": reasoning_tokens(resp.usage),
        "reasoning_content字数": len(getattr(msg, "reasoning_content", None) or ""),
        "答案正确": answer == TEXT_ANSWER,
    })


def image_probe(model: str, variant: str, run: int) -> None:
    """流式看图提取,请求形态与 MaoKit 提取路径一致:stream + json_object + include_usage。"""
    image_b64 = base64.b64encode(IMAGE.read_bytes()).decode()
    started = time.perf_counter()
    first_reasoning = first_content = None
    content, usage = "", None
    try:
        stream = client.chat.completions.create(
            model=model,
            stream=True,
            stream_options={"include_usage": True},
            response_format={"type": "json_object"},
            messages=[{
                "role": "user",
                "content": [
                    {"type": "image_url", "image_url": {"url": f"data:image/png;base64,{image_b64}"}},
                    {"type": "text", "text": IMAGE_PROMPT},
                ],
            }],
            **VARIANTS[variant],
        )
        for chunk in stream:
            if chunk.usage:
                usage = chunk.usage
            if not chunk.choices:
                continue
            delta = chunk.choices[0].delta
            now = time.perf_counter() - started
            if getattr(delta, "reasoning_content", None) and first_reasoning is None:
                first_reasoning = now
            if delta.content:
                first_content = first_content if first_content is not None else now
                content += delta.content
    except openai.APIStatusError as e:
        record({"实验": "看图", "模型": model, "写法": variant, "轮次": run,
                "HTTP": e.status_code, "错误类型": (e.body or {}).get("type")})
        return
    elapsed = time.perf_counter() - started
    parsed = parse_json(content)
    hits = sum(
        any(o in str(parsed.get(k, "")).replace(" ", "") for o in opts)
        for k, opts in GROUND_TRUTH.items()
    )
    record({
        "实验": "看图", "模型": model, "写法": variant, "轮次": run, "HTTP": 200,
        "总耗时秒": round(elapsed, 2),
        "首个思考片段秒": round(first_reasoning, 2) if first_reasoning is not None else None,
        "首个正文秒": round(first_content, 2) if first_content is not None else None,
        "prompt_tokens": usage.prompt_tokens if usage else None,
        "completion_tokens": usage.completion_tokens if usage else None,
        "reasoning_tokens": reasoning_tokens(usage) if usage else None,
        "命中字段": f"{hits}/{len(GROUND_TRUTH)}",
    })


def control_probe(model: str, label: str, extra: dict) -> None:
    """对照组:官方写明「传入会报错」的参数,确认服务端确实会做参数校验。"""
    try:
        client.chat.completions.create(
            model=model, messages=[{"role": "user", "content": "只回复两个字母 OK"}], **extra
        )
        record({"实验": "对照", "模型": model, "写法": label, "HTTP": 200})
    except openai.APIStatusError as e:
        record({"实验": "对照", "模型": model, "写法": label,
                "HTTP": e.status_code, "错误类型": (e.body or {}).get("type")})


def main() -> None:
    record({"环境": {"python": platform.python_version(), "openai": openai.__version__,
                     "开始": time.strftime("%Y-%m-%d %H:%M:%S %z")}})
    jobs = []
    for model in ("kimi-k3.1-pro", "kimi-k3"):
        for variant in VARIANTS:
            for run in (1, 2, 3):
                jobs.append(lambda m=model, v=variant, r=run: text_probe(m, v, r))
        for variant in ("默认", "thinking=disabled"):
            for run in (1, 2):
                jobs.append(lambda m=model, v=variant, r=run: image_probe(m, v, r))
    jobs.append(lambda: control_probe("kimi-k3.1-pro", "temperature=0", {"temperature": 0}))
    jobs.append(lambda: control_probe(
        "kimi-k2.7-code", "thinking=disabled", {"extra_body": {"thinking": {"type": "disabled"}}}))
    for job in jobs:
        job()
        time.sleep(REQUEST_GAP_SECONDS)


if __name__ == "__main__":
    main()
A.2 拓展实验:kimi_thinking_explore.py
"""Kimi K3.1 Pro 关闭思考的拓展用途实测:看图之外的常见用法。

用法:
    export MOONSHOT_API_KEY=sk-****
    uv run --no-project --with openai python kimi_thinking_explore.py

每项都对比「默认(始终思考)」与「thinking=disabled」,结果追加写入同目录的 explore_results.jsonl。
只记录 HTTP 状态、耗时、token 用量、思考内容长度与是否答对,不记录 Key 与模型正文。
"""

import json
import os
import time
import urllib.error
import urllib.request
from pathlib import Path

import openai
from openai import OpenAI

HERE = Path(__file__).resolve().parent
RESULTS = HERE / "explore_results.jsonl"
MODEL = "kimi-k3.1-pro"
REQUEST_GAP_SECONDS = 21  # Tier0 每分钟 3 次请求
API_KEY = os.environ["MOONSHOT_API_KEY"]

client = OpenAI(api_key=API_KEY, base_url="https://api.moonshot.cn/v1", max_retries=0, timeout=600)

VARIANTS = {
    "默认": {},
    "thinking=disabled": {"extra_body": {"thinking": {"type": "disabled"}}},
}


# ---------- 通用工具 ----------

def record(row: dict) -> None:
    print(json.dumps(row, ensure_ascii=False), flush=True)
    with RESULTS.open("a", encoding="utf-8") as f:
        f.write(json.dumps(row, ensure_ascii=False) + "\n")


def pause() -> None:
    time.sleep(REQUEST_GAP_SECONDS)


def parse_json(text: str | None) -> dict:
    try:
        value = json.loads((text or "").strip().removeprefix("```json").removesuffix("```"))
    except json.JSONDecodeError:
        return {}
    return value if isinstance(value, dict) else {}


def metrics(resp, elapsed: float) -> dict:
    msg = resp.choices[0].message
    details = resp.usage.completion_tokens_details
    return {
        "HTTP": 200,
        "耗时秒": round(elapsed, 2),
        "prompt_tokens": resp.usage.prompt_tokens,
        "completion_tokens": resp.usage.completion_tokens,
        "reasoning_tokens": details.reasoning_tokens if details else None,
        "reasoning_content字数": len(getattr(msg, "reasoning_content", None) or ""),
        "finish_reason": resp.choices[0].finish_reason,
    }


def chat(experiment: str, variant: str, run: int = 1, **kwargs):
    """发一次非流式请求并记录指标;失败时记录状态码与错误信息摘要,返回 (resp, row)。"""
    row = {"实验": experiment, "写法": variant, "轮次": run}
    started = time.perf_counter()
    try:
        resp = client.chat.completions.create(model=MODEL, **VARIANTS[variant], **kwargs)
    except openai.APIStatusError as e:
        body = e.body if isinstance(e.body, dict) else {}
        row.update({"HTTP": e.status_code, "错误类型": body.get("type"),
                    "错误信息": str(body.get("message", ""))[:120]})
        return None, row
    row.update(metrics(resp, time.perf_counter() - started))
    return resp, row


# ---------- D1 JSON Mode:从 OCR 文本提取字段 ----------

CONTRACT_TEXT = """采购合同
合同编号:HT-2026-60521
甲方(采购方):甲示例有限公司
乙方(供应方):乙示例有限公司
第一条 标的:服务器 4 台,型号 XS-880,单价人民币 32,100.00 元。
第二条 合同总金额:人民币 128,400.00 元(大写:壹拾贰万捌仟肆佰元整)。
第三条 付款方式:验收合格后 30 日内支付合同总金额的 95%,剩余 5% 作为质保金,质保期满后无息支付。
第四条 签订日期:2026年5月8日。"""

D1_TRUTH = {
    "合同编号": ["HT-2026-60521"],
    "甲方": ["甲示例有限公司"],
    "乙方": ["乙示例有限公司"],
    "合同总金额": ["128,400.00", "128400.00", "128400"],
    "签订日期": ["2026年5月8日", "2026-05-08", "2026-5-8"],
}


def d1_json_mode() -> None:
    prompt = (
        "从下面的合同文本中提取信息,仅返回一个 JSON 对象,字段为"
        ' "合同编号"、"甲方"、"乙方"、"合同总金额"、"签订日期",值照原文填写。\n\n' + CONTRACT_TEXT
    )
    for variant in VARIANTS:
        for run in (1, 2):
            resp, row = chat("D1 JSON Mode 文本提取", variant, run,
                             messages=[{"role": "user", "content": prompt}],
                             response_format={"type": "json_object"})
            if resp:
                parsed = parse_json(resp.choices[0].message.content)
                hits = sum(any(o in str(parsed.get(k, "")).replace(" ", "") for o in opts)
                           for k, opts in D1_TRUTH.items())
                row["命中字段"] = f"{hits}/{len(D1_TRUTH)}"
            record(row)
            pause()


# ---------- D2 Structured Output:json_schema 严格模式 ----------

D2_SCHEMA = {
    "type": "object",
    "properties": {
        "合同编号": {"type": "string"},
        "合同总金额": {"type": "number"},
        "付款节点": {
            "type": "array",
            "items": {
                "type": "object",
                "properties": {"节点": {"type": "string"}, "比例": {"type": "number"}},
                "required": ["节点", "比例"],
                "additionalProperties": False,
            },
        },
    },
    "required": ["合同编号", "合同总金额", "付款节点"],
    "additionalProperties": False,
}


def d2_structured_output() -> None:
    prompt = "从下面的合同文本中提取合同编号、合同总金额(数字)和付款节点(节点说明与百分比数字)。\n\n" + CONTRACT_TEXT
    for variant in VARIANTS:
        resp, row = chat("D2 Structured Output", variant,
                         messages=[{"role": "user", "content": prompt}],
                         response_format={"type": "json_schema",
                                          "json_schema": {"name": "contract", "strict": True, "schema": D2_SCHEMA}})
        if resp:
            parsed = parse_json(resp.choices[0].message.content)
            ratios = sorted(float(n.get("比例", 0)) for n in parsed.get("付款节点", []) if isinstance(n, dict))
            row["结构符合"] = set(parsed) == {"合同编号", "合同总金额", "付款节点"}
            row["金额正确"] = parsed.get("合同总金额") == 128400
            row["付款比例"] = ratios
        record(row)
        pause()


# ---------- D3 批量分类:银行流水摘要归类到费用科目 ----------

D3_ITEMS = [
    ("高铁票 北京南-上海虹桥 出差", "差旅费"),
    ("京东 A4 打印纸 20 箱", "办公费"),
    ("海底捞 宴请客户", "业务招待费"),
    ("国网电费 2026年4月", "水电费"),
    ("写字楼 5 月租金", "租赁费"),
    ("抖音信息流广告投放", "广告费"),
    ("如家酒店 出差住宿 3 晚", "差旅费"),
    ("自来水公司 4 月水费", "水电费"),
    ("晨光签字笔 硒鼓", "办公费"),
    ("分众传媒 电梯广告", "广告费"),
]


def d3_classification() -> None:
    lines = "\n".join(f"{i + 1}. {text}" for i, (text, _) in enumerate(D3_ITEMS))
    prompt = (
        "把下列银行流水摘要逐条归入费用科目,科目只能从「差旅费、办公费、业务招待费、水电费、租赁费、广告费」中选。"
        '仅返回一个 JSON:{"结果": ["科目1", "科目2", ...]},顺序与输入一致。\n\n' + lines
    )
    for variant in VARIANTS:
        for run in (1, 2):
            resp, row = chat("D3 批量分类", variant, run,
                             messages=[{"role": "user", "content": prompt}],
                             response_format={"type": "json_object"})
            if resp:
                labels = parse_json(resp.choices[0].message.content).get("结果", [])
                correct = sum(1 for got, (_, want) in zip(labels, D3_ITEMS) if got == want)
                row["正确条数"] = f"{correct}/{len(D3_ITEMS)}"
            record(row)
            pause()


# ---------- D4 工具调用 ----------

FX_TOOL = {
    "type": "function",
    "function": {
        "name": "get_fx_rate",
        "description": "查询指定日期的外币兑人民币中间价",
        "parameters": {
            "type": "object",
            "properties": {
                "currency": {"type": "string", "description": "币种代码,如 USD"},
                "date": {"type": "string", "description": "日期,格式 YYYY-MM-DD"},
            },
            "required": ["currency", "date"],
        },
    },
}
FX_QUESTION = "2026年3月17日 1 美元兑人民币中间价是多少?请先查询,再计算 3,500 美元折合人民币多少元。"
FX_RESULT = {"currency": "USD", "date": "2026-03-17", "rate": 7.1234}  # 模拟的工具返回值
FX_ANSWER_PATTERNS = ("24931.9", "24,931.9")


def check_tool_call(resp) -> dict:
    calls = resp.choices[0].message.tool_calls or []
    if not calls:
        return {"调用工具": False}
    args = parse_json(calls[0].function.arguments)
    return {"调用工具": calls[0].function.name,
            "参数正确": args.get("currency") == "USD" and args.get("date") == "2026-03-17"}


def d4_tool_calls() -> None:
    messages = [{"role": "user", "content": FX_QUESTION}]
    choices = {
        "auto": None,
        "required": "required",
        "指定函数": {"type": "function", "function": {"name": "get_fx_rate"}},
    }
    for label, tool_choice in choices.items():
        for variant in VARIANTS:
            extra = {"tool_choice": tool_choice} if tool_choice else {}
            resp, row = chat(f"D4 工具调用 tool_choice={label}", variant,
                             messages=messages, tools=[FX_TOOL], **extra)
            if resp:
                row.update(check_tool_call(resp))
            record(row)
            pause()

    # 完整回合:模型发起调用 → 回传工具结果 → 模型给出最终答案
    for variant in VARIANTS:
        resp, row = chat("D4 工具调用完整回合·第1步", variant, messages=messages, tools=[FX_TOOL])
        if resp:
            row.update(check_tool_call(resp))
        record(row)
        pause()
        if not resp or not resp.choices[0].message.tool_calls:
            continue
        assistant = resp.choices[0].message
        # 官方要求原样回传完整 assistant message(思考模式下包括 reasoning_content)
        history = messages + [
            assistant.model_dump(exclude_none=True),
            {"role": "tool", "tool_call_id": assistant.tool_calls[0].id, "content": json.dumps(FX_RESULT)},
        ]
        resp2, row2 = chat("D4 工具调用完整回合·第2步", variant, messages=history, tools=[FX_TOOL])
        if resp2:
            text = (resp2.choices[0].message.content or "").replace(" ", "")
            row2["最终答案正确"] = any(p in text for p in FX_ANSWER_PATTERNS)
        record(row2)
        pause()


# ---------- D5 多轮对话,含中途切换思考开关 ----------

def d5_multi_turn() -> None:
    turn1 = "请记住:本次审计的重要性水平是 120 万元,实际执行的重要性按其 75% 确定。只回复“已记录”。"
    turn2 = "根据刚才的信息,实际执行的重要性是多少万元?只回复数字。"
    for first, second in (("thinking=disabled", "thinking=disabled"),
                          ("默认", "thinking=disabled"),
                          ("thinking=disabled", "默认")):
        label = f"D5 多轮对话 {first}→{second}"
        messages = [{"role": "user", "content": turn1}]
        resp, row = chat(label + "·第1轮", first, messages=messages)
        record(row)
        pause()
        if not resp:
            continue
        messages += [resp.choices[0].message.model_dump(exclude_none=True), {"role": "user", "content": turn2}]
        resp2, row2 = chat(label + "·第2轮", second, messages=messages)
        if resp2:
            row2["答案正确"] = "90" in (resp2.choices[0].message.content or "")
        record(row2)
        pause()


# ---------- D6 Partial Mode:固定开头与 max_tokens 截断 ----------

def d6_partial_mode() -> None:
    prefix = '{"结论": "'
    for variant in VARIANTS:
        resp, row = chat("D6 Partial Mode 固定开头", variant, messages=[
            {"role": "user", "content": "判断:银行存款余额调节表中的未达账项是否需要做账务调整?用 JSON 回答,字段为“结论”和“理由”。"},
            {"role": "assistant", "content": prefix, "partial": True},
        ])
        if resp:
            full = prefix + (resp.choices[0].message.content or "")
            row["拼接后是合法JSON"] = bool(parse_json(full))
        record(row)
        pause()

    # 官方提示:max_tokens 会先被思考消耗,截断点可能落在思考阶段,此时 content 为空
    for variant in VARIANTS:
        resp, row = chat("D6 max_tokens=60 截断", variant, max_tokens=60, messages=[
            {"role": "user", "content": "详细说明审计抽样的五个步骤,每步不少于 100 字。"},
        ])
        if resp:
            row["正文字数"] = len(resp.choices[0].message.content or "")
        record(row)
        pause()


# ---------- D7 长文本:在 120 条的长合同里找两处条款 ----------

def build_long_contract() -> str:
    clauses = []
    for i in range(1, 121):
        if i == 37:
            clauses.append("第37条 甲方逾期付款的,每逾期一日按应付未付金额的万分之五向乙方支付违约金。")
        elif i == 88:
            clauses.append("第88条 质保期为设备验收合格之日起二十六个月,质保期内乙方免费维修。")
        else:
            clauses.append(
                f"第{i}条 双方应当遵守国家有关法律法规及行业规范,按照诚实信用原则履行本合同第{i}条约定的各项义务,"
                "任何一方未经对方书面同意,不得擅自变更或解除本条约定;因本条引起的争议,双方应首先友好协商解决,"
                "协商不成的,任何一方均可向合同签订地有管辖权的人民法院提起诉讼。本条未尽事宜,按照相关法律规定执行。"
            )
    return "\n".join(clauses)


def d7_long_context() -> None:
    doc = build_long_contract()
    prompt = ('阅读下面的合同,仅返回一个 JSON:{"逾期付款违约金": "原文表述", "质保期月数": 数字}。\n\n' + doc)
    for variant in VARIANTS:
        resp, row = chat("D7 长文本条款提取", variant, messages=[{"role": "user", "content": prompt}],
                         response_format={"type": "json_object"})
        if resp:
            parsed = parse_json(resp.choices[0].message.content)
            row["文档字数"] = len(doc)
            row["违约金正确"] = "万分之五" in str(parsed.get("逾期付款违约金", ""))
            row["质保期正确"] = parsed.get("质保期月数") in (26, "26")
        record(row)
        pause()


# ---------- D8 需要推理的题目:什么时候不该关思考 ----------

D8_PROBLEMS = [
    ("日期推算",
     '2026年2月27日是星期五。从这一天算起(这一天记为第1天),第100天是几月几日、星期几?'
     '只返回 JSON:{"日期": "YYYY-MM-DD", "星期": "星期X"}',
     lambda p: p.get("日期") == "2026-06-06" and p.get("星期") in ("星期六", "周六")),
    ("双倍余额递减法",
     "某设备原值 500,000 元,预计净残值率 4%,使用年限 5 年,采用双倍余额递减法计提折旧,"
     '最后两年改按直线法。第 4 年的折旧额是多少元?只返回 JSON:{"第4年折旧额": 数字}',
     lambda p: p.get("第4年折旧额") in (44000, 44000.0, "44000")),
    ("真话假话",
     "甲说“乙在说谎”,乙说“丙在说谎”,丙说“甲和乙都在说谎”。三人中谁说的是真话?"
     '只返回 JSON:{"说真话的人": ["..."]}',
     lambda p: p.get("说真话的人") == ["乙"]),
]


def d8_reasoning() -> None:
    for name, prompt, judge in D8_PROBLEMS:
        for variant in VARIANTS:
            for run in (1, 2):
                resp, row = chat(f"D8 推理题·{name}", variant, run,
                                 messages=[{"role": "user", "content": prompt}],
                                 response_format={"type": "json_object"})
                if resp:
                    row["答案正确"] = bool(judge(parse_json(resp.choices[0].message.content)))
                record(row)
                pause()


# ---------- D9 其他接口:Messages API(Anthropic 兼容)与 Responses API ----------

D9_PROMPT = ("一个仓库月初库存 1280 件,本月三次入库分别为 315、472、198 件,两次出库分别为 640、389 件,"
             '月末又盘亏 17 件。只返回一个 JSON:{"月末库存": 数字},不要输出其他文字。')


def d9_other_apis() -> None:
    for variant, extra in (("默认", {}), ("thinking=disabled", {"thinking": {"type": "disabled"}})):
        request = urllib.request.Request(
            "https://api.moonshot.cn/anthropic/v1/messages",
            data=json.dumps({"model": MODEL, "max_tokens": 4096,
                             "messages": [{"role": "user", "content": D9_PROMPT}], **extra}).encode(),
            headers={"x-api-key": API_KEY, "anthropic-version": "2023-06-01",
                     "content-type": "application/json"},
        )
        row = {"实验": "D9 Messages API", "写法": variant}
        started = time.perf_counter()
        try:
            with urllib.request.urlopen(request, timeout=600) as r:
                body = json.loads(r.read())
            row.update({"HTTP": 200, "耗时秒": round(time.perf_counter() - started, 2),
                        "内容块类型": [b.get("type") for b in body.get("content", [])],
                        "usage": body.get("usage")})
        except urllib.error.HTTPError as e:
            row.update({"HTTP": e.code, "错误信息": e.read().decode(errors="replace")[:120]})
        record(row)
        pause()

    for variant in VARIANTS:
        started = time.perf_counter()
        row = {"实验": "D9 Responses API", "写法": variant}
        try:
            resp = client.responses.create(model=MODEL, input=D9_PROMPT, **VARIANTS[variant])
            details = resp.usage.output_tokens_details
            row.update({"HTTP": 200, "耗时秒": round(time.perf_counter() - started, 2),
                        "输出项类型": [item.type for item in resp.output],
                        "output_tokens": resp.usage.output_tokens,
                        "reasoning_tokens": details.reasoning_tokens if details else None})
        except openai.APIStatusError as e:
            row.update({"HTTP": e.status_code, "错误信息": str(e.body)[:120]})
        record(row)
        pause()


if __name__ == "__main__":
    record({"环境": {"openai": openai.__version__, "开始": time.strftime("%Y-%m-%d %H:%M:%S %z")}})
    for step in (d1_json_mode, d2_structured_output, d3_classification, d4_tool_calls,
                 d5_multi_turn, d6_partial_mode, d7_long_context, d8_reasoning, d9_other_apis):
        try:
            step()
        except Exception as e:  # 单项意外失败不影响后续实验,记录异常类型便于复查
            record({"实验": step.__name__, "脚本异常": f"{type(e).__name__}: {str(e)[:120]}"})
附录 B:原始数据
每行一次请求,"环境" 行标记每一轮的开始时间。
B.1 核心实验
{"环境": {"python": "3.15.0", "openai": "3.37.0", "开始": "2026-10-24 17:42:31 -0700"}}
{"实验": "文本", "模型": "kimi-k3.1-pro", "写法": "默认", "轮次": 1, "HTTP": 200, "耗时秒": 4.23, "completion_tokens": 229, "reasoning_tokens": 206, "reasoning_content字数": 367, "答案正确": true}
{"实验": "文本", "模型": "kimi-k3.1-pro", "写法": "默认", "轮次": 2, "HTTP": 200, "耗时秒": 4.33, "completion_tokens": 161, "reasoning_tokens": 138, "reasoning_content字数": 257, "答案正确": true}
{"实验": "文本", "模型": "kimi-k3.1-pro", "写法": "默认", "轮次": 3, "HTTP": 200, "耗时秒": 4.65, "completion_tokens": 197, "reasoning_tokens": 174, "reasoning_content字数": 310, "答案正确": true}
{"实验": "文本", "模型": "kimi-k3.1-pro", "写法": "thinking=disabled", "轮次": 1, "HTTP": 200, "耗时秒": 1.26, "completion_tokens": 17, "reasoning_tokens": null, "reasoning_content字数": 0, "答案正确": true}
{"实验": "文本", "模型": "kimi-k3.1-pro", "写法": "thinking=disabled", "轮次": 2, "HTTP": 200, "耗时秒": 2.57, "completion_tokens": 18, "reasoning_tokens": null, "reasoning_content字数": 0, "答案正确": true}
{"实验": "文本", "模型": "kimi-k3.1-pro", "写法": "thinking=disabled", "轮次": 3, "HTTP": 200, "耗时秒": 2.57, "completion_tokens": 18, "reasoning_tokens": null, "reasoning_content字数": 0, "答案正确": true}
{"实验": "文本", "模型": "kimi-k3.1-pro", "写法": "reasoning_effort=low", "轮次": 1, "HTTP": 200, "耗时秒": 1.96, "completion_tokens": 54, "reasoning_tokens": 31, "reasoning_content字数": 63, "答案正确": true}
{"实验": "文本", "模型": "kimi-k3.1-pro", "写法": "reasoning_effort=low", "轮次": 2, "HTTP": 200, "耗时秒": 2.91, "completion_tokens": 69, "reasoning_tokens": 46, "reasoning_content字数": 76, "答案正确": true}
{"实验": "文本", "模型": "kimi-k3.1-pro", "写法": "reasoning_effort=low", "轮次": 3, "HTTP": 200, "耗时秒": 3.29, "completion_tokens": 92, "reasoning_tokens": 69, "reasoning_content字数": 124, "答案正确": true}
{"实验": "文本", "模型": "kimi-k3", "写法": "默认", "轮次": 1, "HTTP": 200, "耗时秒": 4.32, "completion_tokens": 161, "reasoning_tokens": 141, "reasoning_content字数": 262, "答案正确": true}
{"实验": "文本", "模型": "kimi-k3", "写法": "默认", "轮次": 2, "HTTP": 200, "耗时秒": 3.59, "completion_tokens": 116, "reasoning_tokens": 95, "reasoning_content字数": 174, "答案正确": true}
{"实验": "文本", "模型": "kimi-k3", "写法": "默认", "轮次": 3, "HTTP": 200, "耗时秒": 4.64, "completion_tokens": 138, "reasoning_tokens": 117, "reasoning_content字数": 204, "答案正确": true}
{"实验": "文本", "模型": "kimi-k3", "写法": "thinking=disabled", "轮次": 1, "HTTP": 200, "耗时秒": 1.45, "completion_tokens": 15, "reasoning_tokens": null, "reasoning_content字数": 0, "答案正确": true}
{"实验": "文本", "模型": "kimi-k3", "写法": "thinking=disabled", "轮次": 2, "HTTP": 200, "耗时秒": 1.34, "completion_tokens": 15, "reasoning_tokens": null, "reasoning_content字数": 0, "答案正确": true}
{"实验": "文本", "模型": "kimi-k3", "写法": "thinking=disabled", "轮次": 3, "HTTP": 200, "耗时秒": 1.6, "completion_tokens": 15, "reasoning_tokens": null, "reasoning_content字数": 0, "答案正确": true}
{"实验": "文本", "模型": "kimi-k3", "写法": "reasoning_effort=low", "轮次": 1, "HTTP": 200, "耗时秒": 2.71, "completion_tokens": 91, "reasoning_tokens": 71, "reasoning_content字数": 131, "答案正确": true}
{"实验": "文本", "模型": "kimi-k3", "写法": "reasoning_effort=low", "轮次": 2, "HTTP": 200, "耗时秒": 14.61, "completion_tokens": 117, "reasoning_tokens": 97, "reasoning_content字数": 169, "答案正确": true}
{"实验": "文本", "模型": "kimi-k3", "写法": "reasoning_effort=low", "轮次": 3, "HTTP": 200, "耗时秒": 3.52, "completion_tokens": 135, "reasoning_tokens": 115, "reasoning_content字数": 208, "答案正确": true}
{"实验": "对照", "模型": "kimi-k3.1-pro", "写法": "temperature=0", "HTTP": 400, "错误类型": "invalid_request_error"}
{"实验": "对照", "模型": "kimi-k2.7-code", "写法": "thinking=disabled", "HTTP": 400, "错误类型": "invalid_request_error"}
{"环境": {"python": "3.15.0", "openai": "3.37.0", "开始": "2026-10-24 18:16:35 -0700", "说明": "更换测试图后只重跑看图实验"}}
{"实验": "看图", "模型": "kimi-k3.1-pro", "写法": "默认", "轮次": 1, "HTTP": 200, "总耗时秒": 6.45, "首个思考片段秒": 2.35, "首个正文秒": 5.83, "prompt_tokens": 744, "completion_tokens": 261, "reasoning_tokens": 198, "命中字段": "5/5"}
{"实验": "看图", "模型": "kimi-k3.1-pro", "写法": "默认", "轮次": 2, "HTTP": 200, "总耗时秒": 7.46, "首个思考片段秒": 3.25, "首个正文秒": 6.91, "prompt_tokens": 744, "completion_tokens": 268, "reasoning_tokens": 205, "命中字段": "5/5"}
{"实验": "看图", "模型": "kimi-k3.1-pro", "写法": "thinking=disabled", "轮次": 1, "HTTP": 200, "总耗时秒": 2.73, "首个思考片段秒": null, "首个正文秒": 2.14, "prompt_tokens": 677, "completion_tokens": 58, "reasoning_tokens": null, "命中字段": "5/5"}
{"实验": "看图", "模型": "kimi-k3.1-pro", "写法": "thinking=disabled", "轮次": 2, "HTTP": 200, "总耗时秒": 3.58, "首个思考片段秒": null, "首个正文秒": 3.02, "prompt_tokens": 677, "completion_tokens": 58, "reasoning_tokens": null, "命中字段": "5/5"}
{"实验": "看图", "模型": "kimi-k3", "写法": "默认", "轮次": 1, "HTTP": 200, "总耗时秒": 4.64, "首个思考片段秒": 1.98, "首个正文秒": 4.0, "prompt_tokens": 744, "completion_tokens": 160, "reasoning_tokens": 99, "命中字段": "5/5"}
{"实验": "看图", "模型": "kimi-k3", "写法": "默认", "轮次": 2, "HTTP": 200, "总耗时秒": 4.15, "首个思考片段秒": 1.33, "首个正文秒": 3.48, "prompt_tokens": 744, "completion_tokens": 174, "reasoning_tokens": 113, "命中字段": "5/5"}
{"实验": "看图", "模型": "kimi-k3", "写法": "thinking=disabled", "轮次": 1, "HTTP": 200, "总耗时秒": 2.72, "首个思考片段秒": null, "首个正文秒": 1.81, "prompt_tokens": 677, "completion_tokens": 55, "reasoning_tokens": null, "命中字段": "5/5"}
{"实验": "看图", "模型": "kimi-k3", "写法": "thinking=disabled", "轮次": 2, "HTTP": 200, "总耗时秒": 6.63, "首个思考片段秒": null, "首个正文秒": 6.02, "prompt_tokens": 677, "completion_tokens": 55, "reasoning_tokens": null, "命中字段": "5/5"}
B.2 拓展实验
{"环境": {"openai": "3.37.0", "开始": "2026-10-24 18:20:28 -0700"}}
{"实验": "D1 JSON Mode 文本提取", "写法": "默认", "轮次": 1, "HTTP": 200, "耗时秒": 6.71, "prompt_tokens": 301, "completion_tokens": 300, "reasoning_tokens": 221, "reasoning_content字数": 698, "finish_reason": "stop", "命中字段": "5/5"}
{"实验": "D1 JSON Mode 文本提取", "写法": "默认", "轮次": 2, "HTTP": 200, "耗时秒": 8.46, "prompt_tokens": 301, "completion_tokens": 357, "reasoning_tokens": 277, "reasoning_content字数": 789, "finish_reason": "stop", "命中字段": "5/5"}
{"实验": "D1 JSON Mode 文本提取", "写法": "thinking=disabled", "轮次": 1, "HTTP": 200, "耗时秒": 2.34, "prompt_tokens": 234, "completion_tokens": 75, "reasoning_tokens": null, "reasoning_content字数": 0, "finish_reason": "stop", "命中字段": "5/5"}
{"实验": "D1 JSON Mode 文本提取", "写法": "thinking=disabled", "轮次": 2, "HTTP": 200, "耗时秒": 3.45, "prompt_tokens": 234, "completion_tokens": 75, "reasoning_tokens": null, "reasoning_content字数": 0, "finish_reason": "stop", "命中字段": "5/5"}
{"实验": "D2 Structured Output", "写法": "默认", "轮次": 1, "HTTP": 200, "耗时秒": 8.42, "prompt_tokens": 379, "completion_tokens": 332, "reasoning_tokens": 261, "reasoning_content字数": 988, "finish_reason": "stop", "结构符合": true, "金额正确": true, "付款比例": [5.0, 95.0]}
{"实验": "D2 Structured Output", "写法": "thinking=disabled", "轮次": 1, "HTTP": 200, "耗时秒": 2.16, "prompt_tokens": 312, "completion_tokens": 57, "reasoning_tokens": null, "reasoning_content字数": 0, "finish_reason": "stop", "结构符合": true, "金额正确": true, "付款比例": [5.0, 95.0]}
{"实验": "D3 批量分类", "写法": "默认", "轮次": 1, "HTTP": 200, "耗时秒": 4.8, "prompt_tokens": 301, "completion_tokens": 214, "reasoning_tokens": 164, "reasoning_content字数": 346, "finish_reason": "stop", "正确条数": "10/10"}
{"实验": "D3 批量分类", "写法": "默认", "轮次": 2, "HTTP": 200, "耗时秒": 4.11, "prompt_tokens": 301, "completion_tokens": 154, "reasoning_tokens": 104, "reasoning_content字数": 241, "finish_reason": "stop", "正确条数": "10/10"}
{"实验": "D3 批量分类", "写法": "thinking=disabled", "轮次": 1, "HTTP": 200, "耗时秒": 1.78, "prompt_tokens": 234, "completion_tokens": 55, "reasoning_tokens": null, "reasoning_content字数": 0, "finish_reason": "stop", "正确条数": "10/10"}
{"实验": "D3 批量分类", "写法": "thinking=disabled", "轮次": 2, "HTTP": 200, "耗时秒": 1.99, "prompt_tokens": 234, "completion_tokens": 45, "reasoning_tokens": null, "reasoning_content字数": 0, "finish_reason": "stop", "正确条数": "10/10"}
{"实验": "D4 工具调用 tool_choice=auto", "写法": "默认", "轮次": 1, "HTTP": 200, "耗时秒": 2.86, "prompt_tokens": 224, "completion_tokens": 115, "reasoning_tokens": 42, "reasoning_content字数": 154, "finish_reason": "tool_calls", "调用工具": "get_fx_rate", "参数正确": true}
{"实验": "D4 工具调用 tool_choice=auto", "写法": "thinking=disabled", "轮次": 1, "HTTP": 200, "耗时秒": 2.55, "prompt_tokens": 157, "completion_tokens": 100, "reasoning_tokens": null, "reasoning_content字数": 0, "finish_reason": "tool_calls", "调用工具": "get_fx_rate", "参数正确": true}
{"实验": "D4 工具调用 tool_choice=required", "写法": "默认", "轮次": 1, "HTTP": 200, "耗时秒": 3.36, "prompt_tokens": 260, "completion_tokens": 137, "reasoning_tokens": 64, "reasoning_content字数": 236, "finish_reason": "tool_calls", "调用工具": "get_fx_rate", "参数正确": true}
{"实验": "D4 工具调用 tool_choice=required", "写法": "thinking=disabled", "轮次": 1, "HTTP": 200, "耗时秒": 2.36, "prompt_tokens": 193, "completion_tokens": 68, "reasoning_tokens": null, "reasoning_content字数": 0, "finish_reason": "tool_calls", "调用工具": "get_fx_rate", "参数正确": true}
{"实验": "D4 工具调用 tool_choice=指定函数", "写法": "默认", "轮次": 1, "HTTP": 400, "错误类型": "invalid_request_error", "错误信息": "tool_choice 'specified' is incompatible with thinking enabled"}
{"实验": "D4 工具调用 tool_choice=指定函数", "写法": "thinking=disabled", "轮次": 1, "HTTP": 200, "耗时秒": 3.71, "prompt_tokens": 157, "completion_tokens": 92, "reasoning_tokens": null, "reasoning_content字数": 0, "finish_reason": "tool_calls", "调用工具": "get_fx_rate", "参数正确": true}
{"实验": "D4 工具调用完整回合·第1步", "写法": "默认", "轮次": 1, "HTTP": 200, "耗时秒": 4.81, "prompt_tokens": 224, "completion_tokens": 169, "reasoning_tokens": 96, "reasoning_content字数": 393, "finish_reason": "tool_calls", "调用工具": "get_fx_rate", "参数正确": true}
{"实验": "D4 工具调用完整回合·第2步", "写法": "默认", "轮次": 1, "HTTP": 200, "耗时秒": 5.84, "prompt_tokens": 448, "completion_tokens": 288, "reasoning_tokens": 199, "reasoning_content字数": 502, "finish_reason": "stop", "最终答案正确": true}
{"实验": "D4 工具调用完整回合·第1步", "写法": "thinking=disabled", "轮次": 1, "HTTP": 200, "耗时秒": 3.55, "prompt_tokens": 157, "completion_tokens": 100, "reasoning_tokens": null, "reasoning_content字数": 0, "finish_reason": "tool_calls", "调用工具": "get_fx_rate", "参数正确": true}
{"实验": "D4 工具调用完整回合·第2步", "写法": "thinking=disabled", "轮次": 1, "HTTP": 200, "耗时秒": 3.34, "prompt_tokens": 312, "completion_tokens": 131, "reasoning_tokens": null, "reasoning_content字数": 0, "finish_reason": "stop", "最终答案正确": true}
{"实验": "D5 多轮对话 thinking=disabled→thinking=disabled·第1轮", "写法": "thinking=disabled", "轮次": 1, "HTTP": 200, "耗时秒": 2.0, "prompt_tokens": 46, "completion_tokens": 12, "reasoning_tokens": null, "reasoning_content字数": 0, "finish_reason": "stop"}
{"实验": "D5 多轮对话 thinking=disabled→thinking=disabled·第2轮", "写法": "thinking=disabled", "轮次": 1, "HTTP": 200, "耗时秒": 1.95, "prompt_tokens": 90, "completion_tokens": 11, "reasoning_tokens": null, "reasoning_content字数": 0, "finish_reason": "stop", "答案正确": true}
{"实验": "D5 多轮对话 默认→thinking=disabled·第1轮", "写法": "默认", "轮次": 1, "HTTP": 200, "耗时秒": 2.83, "prompt_tokens": 113, "completion_tokens": 81, "reasoning_tokens": 64, "reasoning_content字数": 271, "finish_reason": "stop"}
{"实验": "D5 多轮对话 默认→thinking=disabled·第2轮", "写法": "thinking=disabled", "轮次": 1, "HTTP": 200, "耗时秒": 2.75, "prompt_tokens": 90, "completion_tokens": 11, "reasoning_tokens": null, "reasoning_content字数": 0, "finish_reason": "stop", "答案正确": true}
{"实验": "D5 多轮对话 thinking=disabled→默认·第1轮", "写法": "thinking=disabled", "轮次": 1, "HTTP": 200, "耗时秒": 2.73, "prompt_tokens": 46, "completion_tokens": 12, "reasoning_tokens": null, "reasoning_content字数": 0, "finish_reason": "stop"}
{"实验": "D5 多轮对话 thinking=disabled→默认·第2轮", "写法": "默认", "轮次": 1, "HTTP": 200, "耗时秒": 2.14, "prompt_tokens": 163, "completion_tokens": 50, "reasoning_tokens": 34, "reasoning_content字数": 127, "finish_reason": "stop", "答案正确": true}
{"实验": "D6 Partial Mode 固定开头", "写法": "默认", "轮次": 1, "HTTP": 200, "耗时秒": 2.52, "prompt_tokens": 122, "completion_tokens": 59, "reasoning_tokens": null, "reasoning_content字数": 0, "finish_reason": "stop", "拼接后是合法JSON": true}
{"实验": "D6 Partial Mode 固定开头", "写法": "thinking=disabled", "轮次": 1, "HTTP": 200, "耗时秒": 3.45, "prompt_tokens": 55, "completion_tokens": 72, "reasoning_tokens": null, "reasoning_content字数": 0, "finish_reason": "stop", "拼接后是合法JSON": true}
{"实验": "D6 max_tokens=60 截断", "写法": "默认", "轮次": 1, "HTTP": 200, "耗时秒": 2.57, "prompt_tokens": 101, "completion_tokens": 60, "reasoning_tokens": 57, "reasoning_content字数": 98, "finish_reason": "length", "正文字数": 0}
{"实验": "D6 max_tokens=60 截断", "写法": "thinking=disabled", "轮次": 1, "HTTP": 200, "耗时秒": 3.14, "prompt_tokens": 34, "completion_tokens": 60, "reasoning_tokens": null, "reasoning_content字数": 0, "finish_reason": "length", "正文字数": 117}
{"实验": "D7 长文本条款提取", "写法": "默认", "轮次": 1, "HTTP": 200, "耗时秒": 7.15, "prompt_tokens": 9879, "completion_tokens": 278, "reasoning_tokens": 230, "reasoning_content字数": 406, "finish_reason": "stop", "文档字数": 17681, "违约金正确": true, "质保期正确": true}
{"实验": "D7 长文本条款提取", "写法": "thinking=disabled", "轮次": 1, "HTTP": 200, "耗时秒": 2.36, "prompt_tokens": 9812, "completion_tokens": 43, "reasoning_tokens": null, "reasoning_content字数": 0, "finish_reason": "stop", "文档字数": 17681, "违约金正确": true, "质保期正确": true}
{"实验": "D8 推理题·日期推算", "写法": "默认", "轮次": 1, "HTTP": 200, "耗时秒": 10.26, "prompt_tokens": 182, "completion_tokens": 499, "reasoning_tokens": 470, "reasoning_content字数": 1363, "finish_reason": "stop", "答案正确": true}
{"实验": "D8 推理题·日期推算", "写法": "默认", "轮次": 2, "HTTP": 200, "耗时秒": 7.11, "prompt_tokens": 182, "completion_tokens": 295, "reasoning_tokens": 266, "reasoning_content字数": 777, "finish_reason": "stop", "答案正确": true}
{"实验": "D8 推理题·日期推算", "写法": "thinking=disabled", "轮次": 1, "HTTP": 200, "耗时秒": 1.15, "prompt_tokens": 115, "completion_tokens": 27, "reasoning_tokens": null, "reasoning_content字数": 0, "finish_reason": "stop", "答案正确": true}
{"实验": "D8 推理题·日期推算", "写法": "thinking=disabled", "轮次": 2, "HTTP": 200, "耗时秒": 1.03, "prompt_tokens": 115, "completion_tokens": 27, "reasoning_tokens": null, "reasoning_content字数": 0, "finish_reason": "stop", "答案正确": true}
{"实验": "D8 推理题·双倍余额递减法", "写法": "默认", "轮次": 1, "HTTP": 200, "耗时秒": 6.97, "prompt_tokens": 196, "completion_tokens": 271, "reasoning_tokens": 246, "reasoning_content字数": 436, "finish_reason": "stop", "答案正确": true}
{"实验": "D8 推理题·双倍余额递减法", "写法": "默认", "轮次": 2, "HTTP": 200, "耗时秒": 7.02, "prompt_tokens": 196, "completion_tokens": 232, "reasoning_tokens": 207, "reasoning_content字数": 705, "finish_reason": "stop", "答案正确": true}
{"实验": "D8 推理题·双倍余额递减法", "写法": "thinking=disabled", "轮次": 1, "HTTP": 200, "耗时秒": 1.73, "prompt_tokens": 129, "completion_tokens": 21, "reasoning_tokens": null, "reasoning_content字数": 0, "finish_reason": "stop", "答案正确": false}
{"实验": "D8 推理题·双倍余额递减法", "写法": "thinking=disabled", "轮次": 2, "HTTP": 200, "耗时秒": 3.12, "prompt_tokens": 129, "completion_tokens": 21, "reasoning_tokens": null, "reasoning_content字数": 0, "finish_reason": "stop", "答案正确": false}
{"实验": "D8 推理题·真话假话", "写法": "默认", "轮次": 1, "HTTP": 200, "耗时秒": 8.02, "prompt_tokens": 174, "completion_tokens": 295, "reasoning_tokens": 272, "reasoning_content字数": 925, "finish_reason": "stop", "答案正确": true}
{"实验": "D8 推理题·真话假话", "写法": "默认", "轮次": 2, "HTTP": 200, "耗时秒": 8.47, "prompt_tokens": 174, "completion_tokens": 285, "reasoning_tokens": 262, "reasoning_content字数": 407, "finish_reason": "stop", "答案正确": true}
{"实验": "D8 推理题·真话假话", "写法": "thinking=disabled", "轮次": 1, "HTTP": 200, "耗时秒": 1.73, "prompt_tokens": 107, "completion_tokens": 18, "reasoning_tokens": null, "reasoning_content字数": 0, "finish_reason": "stop", "答案正确": true}
{"实验": "D8 推理题·真话假话", "写法": "thinking=disabled", "轮次": 2, "HTTP": 200, "耗时秒": 1.51, "prompt_tokens": 107, "completion_tokens": 18, "reasoning_tokens": null, "reasoning_content字数": 0, "finish_reason": "stop", "答案正确": true}
{"实验": "D9 Messages API", "写法": "默认", "HTTP": 200, "耗时秒": 4.64, "内容块类型": ["thinking", "text"], "usage": {"input_tokens": 145, "cache_creation_input_tokens": 0, "cache_read_input_tokens": 0, "output_tokens": 155, "cache_creation": {"ephemeral_5m_input_tokens": 0, "ephemeral_1h_input_tokens": 0}, "output_tokens_details": {"thinking_tokens": 133}, "service_tier": "standard", "inference_geo": "not_available", "prompt_tokens": 145, "cached_tokens": 0, "completion_tokens": 155, "total_tokens": 300}}
{"实验": "D9 Messages API", "写法": "thinking=disabled", "HTTP": 200, "耗时秒": 2.42, "内容块类型": ["text"], "usage": {"input_tokens": 78, "cache_creation_input_tokens": 0, "cache_read_input_tokens": 0, "output_tokens": 18, "cache_creation": {"ephemeral_5m_input_tokens": 0, "ephemeral_1h_input_tokens": 0}, "service_tier": "standard", "inference_geo": "not_available", "prompt_tokens": 78, "cached_tokens": 0, "completion_tokens": 18, "total_tokens": 96}}
{"实验": "D9 Responses API", "写法": "默认", "HTTP": 200, "耗时秒": 3.86, "输出项类型": ["reasoning", "message"], "output_tokens": 89, "reasoning_tokens": 67}
{"实验": "D9 Responses API", "写法": "thinking=disabled", "HTTP": 200, "耗时秒": 4.78, "输出项类型": ["reasoning", "message"], "output_tokens": 160, "reasoning_tokens": 137}
版权声明:本文为原创文章,如需转载请注明来源。